Más datos, menos claridad
¿Estamos avanzando en comprensión o solo generando más datos?

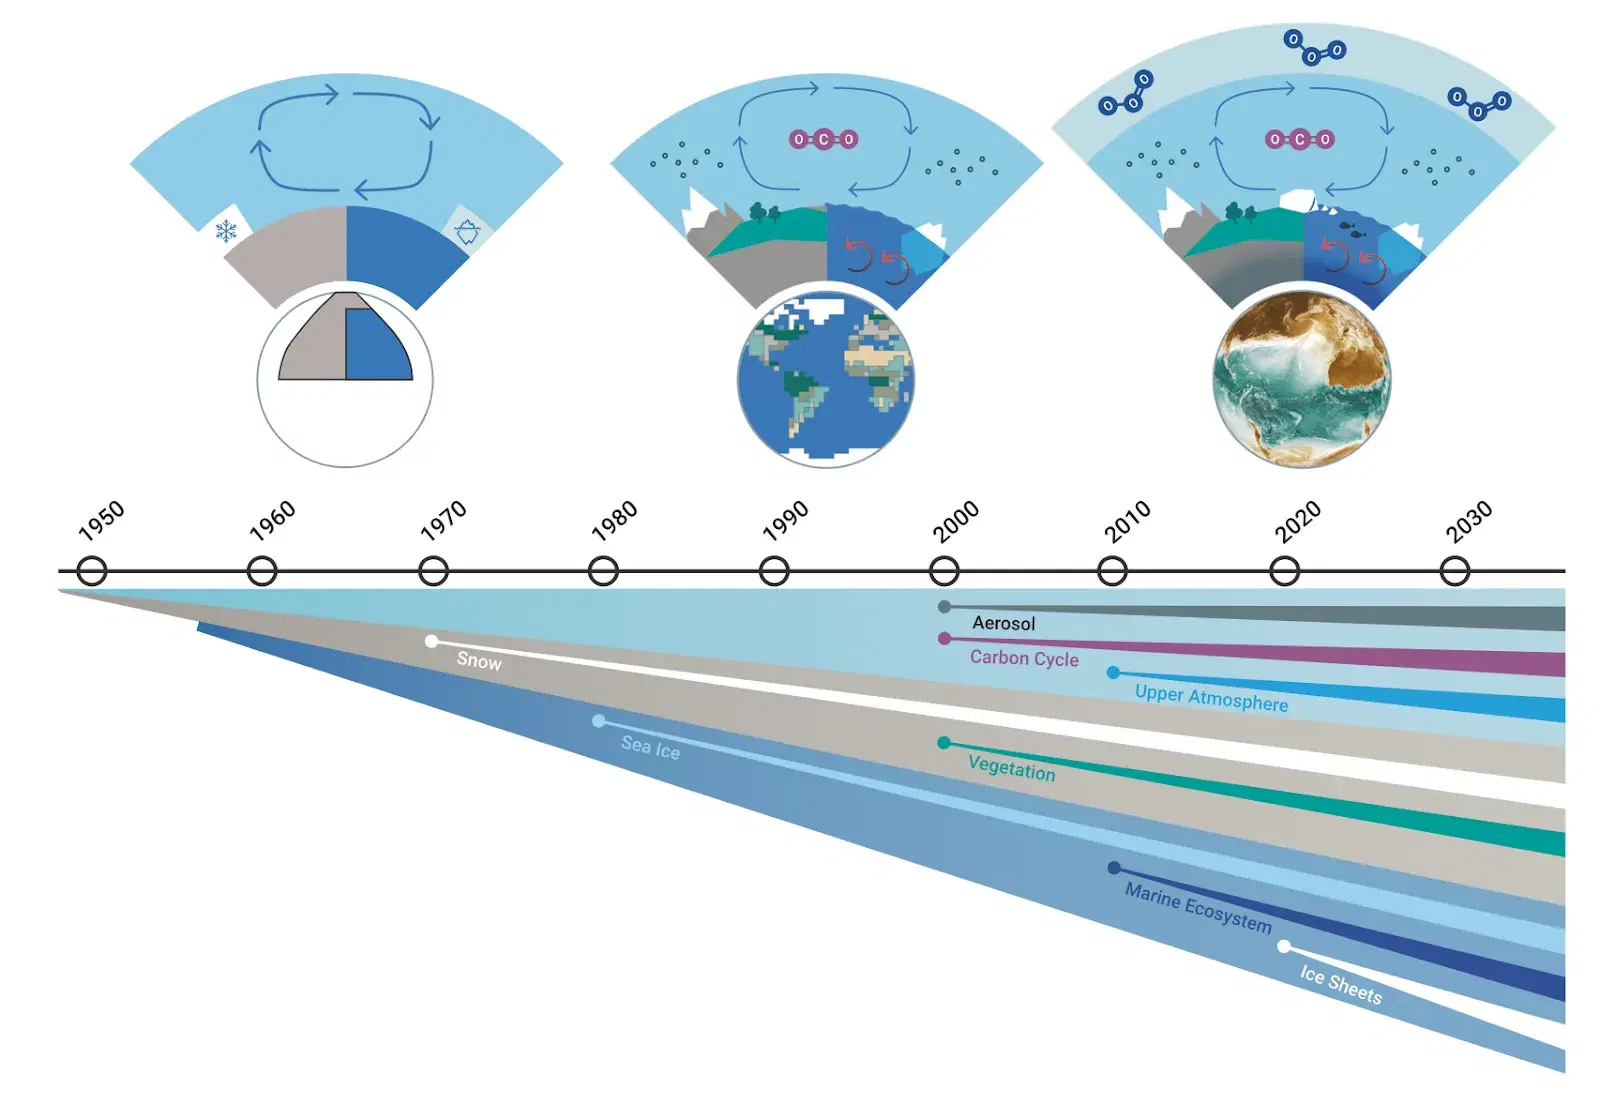
Evolución de los componentes de los modelos climáticos hacia modelos del sistema Tierra totalmente acoplados
Hoy los modelos climáticos pueden simular todo el sistema Tierra con un nivel de detalle extraordinario. Integran la química atmosférica, la biogeoquímica oceánica, la dinámica de las capas de hielo y los procesos de la superficie terrestre en marcos computacionales unificados que habrían sido inimaginables hace una generación. Pero en el corazón de este progreso hay una paradoja: los modelos son cada vez mejores produciendo datos, y nosotros no avanzamos al mismo ritmo en entender qué significan esos datos.
Lo que comenzó como simulaciones de la física básica de la atmósfera y el océano se ha transformado en Modelos del Sistema Tierra (ESM, por sus siglas en inglés) que integran procesos biogeofísicos y químicos complejos. Los avances en la teledetección satelital y la supercomputación hicieron posible este salto, pero también crearon un problema inesperado: los modelos ahora generan datos más rápido de lo que pueden analizarse de forma significativa (Bordoni et al., 2025).
El equilibrio productivo entre observación, teoría y modelación que históricamente impulsó a la ciencia del clima se está rompiendo. La capacidad computacional se ha disparado. La comprensión teórica no ha seguido el paso. Y el resultado es una brecha creciente entre lo que podemos simular y lo que realmente comprendemos del sistema climático (Emanuel, 2020).
El problema de la avalancha de datos
El Proyecto de Intercomparación de Modelos Acoplados (CMIP) ilustra claramente esta tensión. CMIP es el mayor esfuerzo coordinado de la ciencia del clima: decenas de centros de modelación en todo el mundo ejecutan sus modelos bajo protocolos experimentales compartidos y producen un archivo común de simulaciones que sustenta la mayor parte de lo que sabemos, y de lo que afirmamos saber, sobre el cambio climático futuro. Las evaluaciones del IPCC, los planes nacionales de adaptación y los productos de riesgo climático se basan en gran medida en los resultados de CMIP.
La última fase completada, CMIP6, produjo petabytes de datos. Se proyecta que las fases futuras generen alrededor de 300 petabytes. Sin embargo, algunas preguntas fundamentales siguen obstinadamente sin respuesta.
Los modelos de CMIP6 muestran una sensibilidad climática mayor que sus predecesores de CMIP5, y todavía no podemos explicar del todo por qué. ¿Son estos cambios avances genuinos en la representación de procesos físicos como las retroalimentaciones de las nubes y las interacciones de los aerosoles? ¿O son artefactos de errores compensatorios que casualmente producen números distintos? El enorme volumen de resultados hace más difícil, no más fácil, diagnosticar dónde la física se aparta de la realidad.
La gestión de datos se ha convertido en una disciplina en sí misma: necesaria, pero insuficiente. Almacenar, indexar y distribuir petabytes de resultados de modelos es un logro de ingeniería. No es, por sí solo, un logro científico. Y cuando la disponibilidad de datos empieza a dictar la agenda de investigación, desplazando la indagación guiada por hipótesis en favor de la exploración guiada por datos, algo importante se pierde (Byrne et al., 2024).
Lo que realmente aporta la teoría
Consideremos un ejemplo concreto. En meteorología tropical, décadas de trabajo teórico sobre el cuasiequilibrio convectivo y la teoría de la intensidad potencial dieron a los investigadores un marco para entender por qué se intensifican los ciclones tropicales, qué fija su límite superior y cómo un clima más cálido podría desplazar esos límites. Este andamiaje teórico permite que, cuando un modelo de alta resolución produce la simulación de un huracán, los científicos puedan evaluar si el resultado es físicamente plausible, y no solo si parece realista.
Sin ese tipo de fundamento teórico, un modelo se convierte en un oráculo: produce respuestas, pero nadie puede explicar por qué deberíamos confiar en ellas. En la ciencia del clima, donde las decisiones dependen de proyecciones a décadas vista, esta distinción importa enormemente.
No se trata de que la modelación computacional esté mal encaminada. Se trata de que la teoría y la modelación son complementarias, y el equilibrio entre ambas se ha inclinado demasiado hacia un lado. Aprovechar al máximo el valor de los resultados de modelos existentes requiere un esfuerzo focalizado para diagnosticar los errores de los modelos, identificar qué procesos mejoran genuinamente la capacidad predictiva y separar las señales robustas del ruido computacional.
Lo que está en juego para el riesgo climático
Esta tensión no se limita al ámbito académico. Se manifiesta directamente en el sector de la tecnología climática, donde existe la misma tentación: suponer que más datos y mayor resolución producen automáticamente mejores productos.
No es así.
Cuando los modelos muestran sensibilidades climáticas divergentes y las proyecciones regionales varían ampliamente, la pregunta clave no es qué modelo tiene la malla más fina. Es qué procesos físicos determinan la predictibilidad de las variables que importan para decisiones reales: los umbrales de precipitación que activan pagos de seguros, los extremos de temperatura que ponen bajo presión la infraestructura, los índices de sequía que orientan la planificación agrícola.
Un producto de riesgo climático que no puede explicar la base física de sus predicciones es fundamentalmente limitado, sin importar cuánta computación haya detrás. Si dos modelos no coinciden sobre las tendencias futuras de lluvia en una región determinada, quien trabaja con ellos necesita entender por qué no coinciden (qué parametrización de nubes difiere, qué retroalimentación de la superficie terrestre se trata de forma distinta) para emitir un juicio informado sobre qué proyección merece confianza.
Esto exige un tipo de experiencia que se ubica en la intersección entre la física del clima y la ciencia de datos aplicada. Ninguna de las dos disciplinas es suficiente por sí sola. Los científicos del clima aportan la comprensión física del comportamiento de los modelos; los científicos de datos aportan las herramientas para extraer señal de conjuntos de datos masivos y ruidosos. La ventaja competitiva es de las organizaciones capaces de combinar ambas.
La ventana se está cerrando
La ventana para la acción climática no va a esperar a que los modelos converjan. Las decisiones de adaptación, las inversiones en infraestructura y las evaluaciones de riesgo se están tomando ahora, sobre la base de proyecciones climáticas cuyas incertidumbres no siempre están bien caracterizadas.
El camino a seguir no es simplemente más capacidad de cómputo o conjuntos de datos más grandes. Es claridad conceptual: comprender la física del clima lo suficientemente bien como para saber qué predicciones son robustas, qué incertidumbres pueden reducirse con mejores observaciones o teoría, y cuáles seguirán siendo irreducibles sin importar los recursos computacionales.
El cuello de botella no son los datos. Es la comprensión.
Referencias
- Bordoni, S., Kang, S.M., Shaw, T.A. et al. The futures of climate modeling. npj Clim Atmos Sci 8, 99 (2025). https://doi.org/10.1038/s41612-025-00955-8
- Byrne, M.P., Hegerl, G.C., Scheff, J. et al. Theory and the future of land-climate science. Nat. Geosci. 17, 1079–1086 (2024). https://doi.org/10.1038/s41561-024-01553-8
- Emanuel, K. A. (2020). The relevance of theory for contemporary research in atmospheres, oceans, and climate. AGU Advances, 1(2), e2019AV000129. https://doi.org/10.1029/2019AV000129